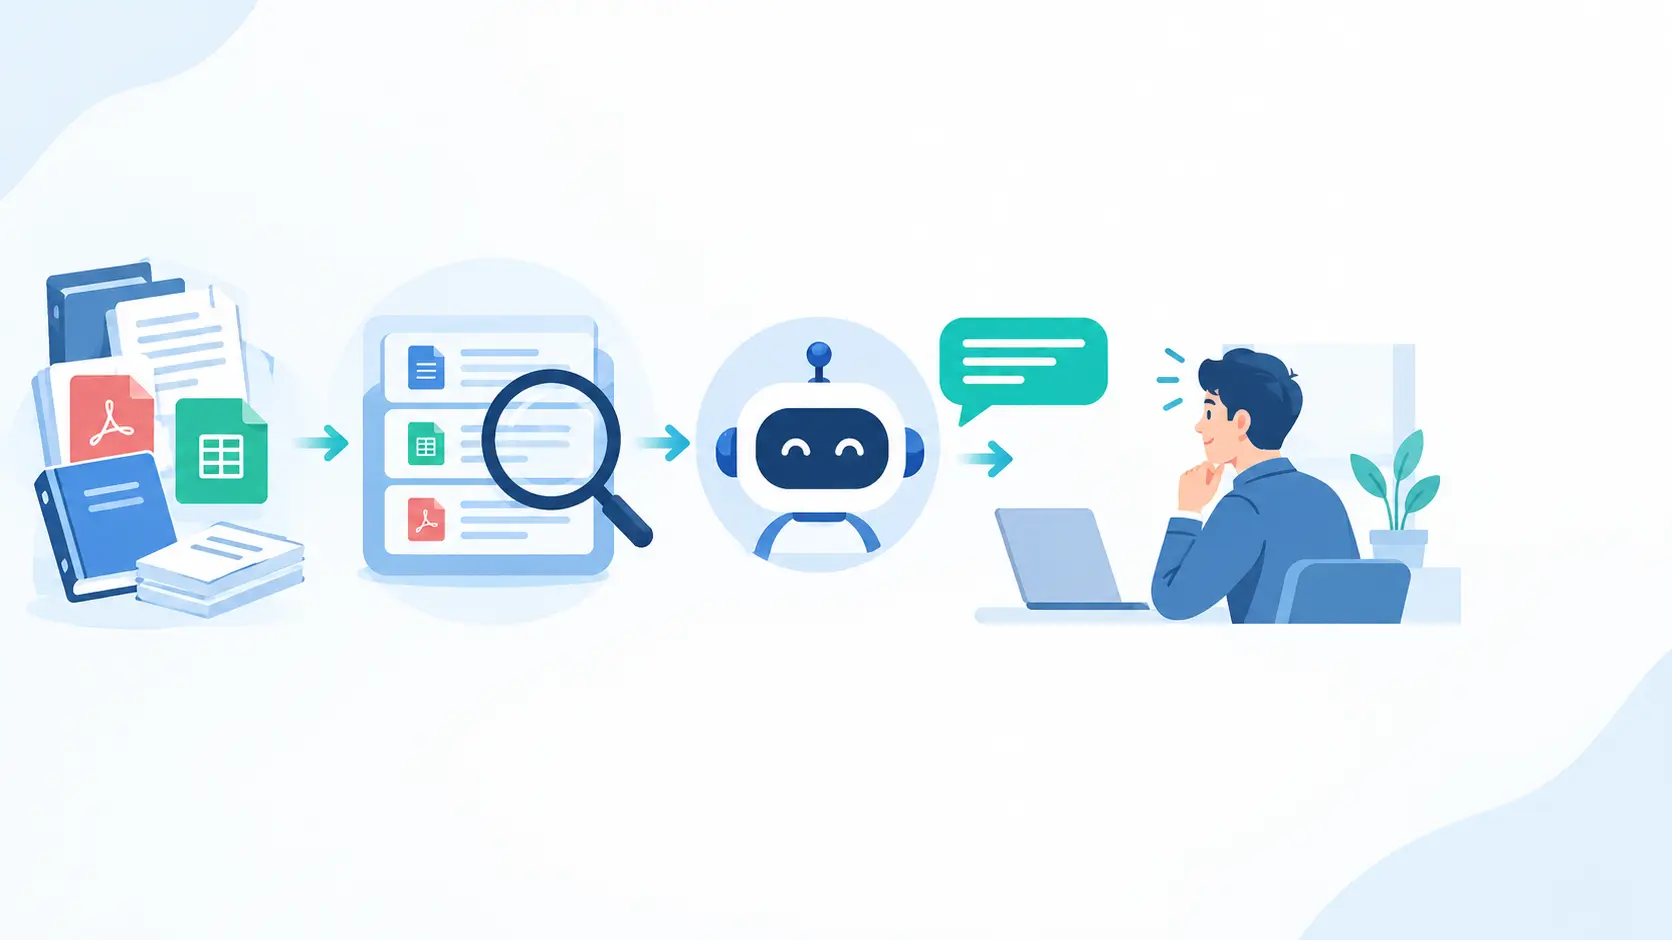
「社内の規程やマニュアルをもとに、生成AIに質問へ答えてほしい」。そんなときに検討されるのが、RAG(ラグ)という仕組みです。
この記事は、生成AIで社内の業務効率化を考えている企業の担当者に向けたものです。RAGを作るときの流れを、準備から運用まで順に説明します。
読み終えると、次の3点がわかります。
- RAGの仕組みと、完成までの全体像
- 構築の6つのステップと、それぞれで決めること
- ノーコードツール・クラウドサービス・自前実装の3つの作り方と、選び方の目安
専門用語には補足を付けています。社内での検討や、外部への相談の準備にお役立てください。
RAGとは:生成AIが社内文書を調べてから答える仕組み
RAGは、生成AIが回答する前に社内文書などを検索し、見つけた内容をもとに答える仕組みです。
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と訳されます。2020年に発表された論文で提案された手法です。
出典:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks、2020年5月初版
生成AIは、モデルの学習に使われたデータなどをもとに回答を生成します。そのため、自社の就業規則や製品マニュアルなど、モデルが学習していない社内情報を参照して答えることはできません。RAGでは、質問に関係する社内文書を先に探し、その内容を回答に必要な情報として生成AIに渡します。
たとえるなら、記憶だけで答える試験を、資料を見ながら答えてよい「持ち込み可」の試験に変えるようなものです。参照した資料を回答と一緒に示せるのも特徴です。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
追加学習(ファインチューニング)との違い
RAGは、AIそのものを学習し直す方法ではありません。
ファインチューニング(AIモデルに追加のデータを学習させて調整すること)は、AIの中身を変える方法です。RAGは、AIの中身は変えず、質問のたびに参照資料を渡します。AWSの公式ドキュメントも、RAGを使えば非公開データのためにモデルを学習し続ける必要がなくなると説明しています。
Microsoftは、使い分けの目安を次のように示しています。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
| 比べる点 | RAG | ファインチューニング |
|---|---|---|
| 向いている用途 | 社内の非公開データや、よく変わる情報にもとづいて答えたい | 新しい知識ではなく、AIの振る舞いや文体を変えたい |
| AIモデル | そのまま使う | 追加学習で調整する |
| 情報が変わったとき | 参照する文書を入れ替える | 学習し直す |
社内規程やマニュアルのように改定される文書を扱うなら、まずRAGを検討するのが自然です。
企業での生成AIの利用状況
日本企業でも、生成AIの業務利用は広がっています。
総務省の調査では、何らかの業務で生成AIを使っている日本企業は86.4%でした。業務別では、議事録・メール作成補助が約7割、営業・販売が約6割、社内ヘルプデスクが約5割です。
出典:総務省「令和8年版 情報通信白書|生成AIの業務利用状況」、2025年度調査
生成AIを「積極的に活用する」または「領域を限定して活用する」方針の企業は68.9%で、前年度の49.7%から上昇しました。
出典:総務省「令和8年版 情報通信白書|生成AIの活用方針等」、2025年度調査
社内ヘルプデスクのように、社内の決まりや手順を調べて答える業務は、RAGの仕組みと相性がよい業務です。一般的な生成AIでは社内の決まりを参照できないためです。
RAG構築の全体像:2つの流れでとらえる
RAGの仕組みは、事前に文書を検索できる状態にしておく「データを準備する流れ」と、質問を受けて文書を検索し回答を作る「質問に答える流れ」の2つに分けて考えると理解しやすくなります。
この記事では、埋め込みモデル(文章を数値のベクトルに変換するAIモデル)を使い、意味の近さで文書を探す構成を例に説明します。
なお、RAGにベクトル化は必須ではありません。埋め込みモデルを使わず、キーワードの一致で文書を探す索引(インデックス)を使う方法もあります。たとえばDifyには、埋め込みモデルを呼び出さずにキーワードで索引を作る「コスト効率」モードがあります。Microsoftも、RAGの検索方式としてキーワード検索、ベクトル検索、両者を組み合わせたハイブリッド検索などを挙げています。
出典:Dify Docs「ステップ 2:ナレッジパイプラインをオーケストレーションする」、Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
① データを準備する流れ(事前に行う)
まず、参照させたい社内文書をテキストにして、扱いやすい大きさに分けます。分けたかたまりを「チャンク」と呼びます。
埋め込みモデルを使う構成では、次に各チャンクを「ベクトル」と呼ばれる数値の並びに変換します。この変換を「埋め込み(エンベディング)」といいます。数値にすることで、文章同士の意味の近さを計算で比べられるようになります。最後に、元の文書との対応を保ったまま、検索用の索引(インデックス)に保存します。
② 質問に答える流れ(使うたびに行う)
社員が質問すると、質問文も同じように数値に変換されます。その数値と近いチャンクを索引から探し、質問と一緒にAIに渡します。AIは渡された文書をもとに回答を作り、参照元を示すこともできます。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
構築で手間がかかるのは、主に①の準備の流れです。②の回答の質は、①でどんな文書をどう整えたかに大きく左右されます。Microsoftも、RAGの品質はデータの準備、検索の設定、指示文の設計によって変わると明記しています。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
RAG構築の手順(6ステップ)
ここでは、Microsoftの設計ガイドの考え方も参考にしながら、企業がRAGを導入するときの流れを「目的を決める → 評価の基準を作る → 文書を整える → 作る → 試す → 改善する」の6つのステップに整理します。Microsoftの設計ガイドは、準備から評価までを段階に分け、各段階を評価しながら進めるよう勧めています。
① 目的と対象業務を決める
最初に、「誰の、どんな質問に答えるものか」を決めます。
対象が広すぎると、集める文書も評価の基準も定まりません。「総務への社内規程の問い合わせ」「営業担当による製品仕様の確認」のように、業務と利用者を絞って始めるのが現実的です。
決めておくことは次の3つです。
- 対象の業務と、使う人
- 今その業務にかかっている手間(問い合わせ件数、調べものにかかる時間など)
- 導入後に何がどうなれば「効果があった」と判断するか
② 評価用の質問と正解を用意する
作り始める前に、「この質問にはこう答えてほしい」という質問と正解の組み合わせを用意します。これが完成を判断する基準になります。
Microsoftの設計ガイドも、最初の準備段階でテスト用の文書と質問を集めるよう求めています。後述する横浜市の実証でも、あらかじめ用意した質問に想定どおりの回答が返るかで精度を測っています。
質問は、過去の問い合わせ履歴やFAQから集めると、実際の使われ方に近い評価ができます。文書に答えがない質問も混ぜておくと、「わからないときに正しく『わからない』と答えるか」も確かめられます。
③ 文書を集めて整える
参照させる文書を集め、AIが読み取りやすい状態に整えます。回答の質を大きく左右する工程です。
主な作業は次のとおりです。
- 古い版の規程や、内容が重複・矛盾している文書を除く
- スキャンしたPDFや画像は、文字として読める状態にする
- 文字化けや余計な改行など、意味のないノイズを取り除く
- 文書ごとに、部署・更新日・公開範囲などの補足情報(メタデータ)を付ける
古い版と新しい版が両方残っていると、AIが古い内容で答えてしまうおそれがあります。Microsoftも、データの準備が不適切だと回答の質に直接影響すると明記しています。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
参照させる文書は、どのファイル形式がよいか
多くのRAGツールやサービスでは、WordやPDFなどの一般的な文書形式を取り込めます。ただし、対応する形式や容量、読み取り方法はサービスによって異なります。形式そのものより、「文字として読み取れるか」と「見出しなどの構造がはっきりしているか」が回答の質を左右します。
たとえばAmazon Bedrockのナレッジベースは、テキスト(.txt)、Markdown(.md)、HTML(.html)、Word(.doc/.docx)、CSV(.csv)、Excel(.xls/.xlsx)、PDF(.pdf)に対応し、1ファイル50MBまでとされています。Difyも、PDF、Excel、Wordなどのファイルを取り込めます。1ファイルの上限は15MB(有料のProfessional・Teamプランは50MB)です。
出典:Amazon Bedrock ナレッジベースデータの前提条件、Dify Docs「ステップ 2:ナレッジパイプラインをオーケストレーションする」
形式ごとの注意点は次のとおりです。
- Word(.docx):そのまま取り込めます。見出しを付けて章立てしておくと、文書を区切るときの手がかりになります。
- PDF(WordやExcelから書き出したもの):文字の情報を含むため、そのまま取り込めます。
- PDF(紙をスキャンしたもの)・画像:見た目は文字でも、中身は画像です。OCR(画像から文字を読み取る処理)でテキストにする必要があります。
- 図・表・グラフが多い文書:どこまで読み取れるかは、使う解析方法によって変わります。たとえばAmazon Bedrockでは、標準の解析方法は文字だけを取り出します。図・表・グラフなども読み取れる解析方法も用意されていますが、別途料金がかかり、対応範囲も方法によって異なります。構築時には最新の仕様を確認してください。
- Excel・CSV:表のデータを取り込めます。Difyには、「質問」と「回答」の列を持つFAQの表を、質問と回答の組として取り込む機能もあります。
- テキスト・Markdown・HTML:装飾がなく、そのまま文字として扱えます。
スキャンした文書をテキストにする方法は、「AI OCR とは?従来のOCRとの違いから実装方法まで解説」で詳しく解説しています。
今あるファイルを、無理に別の形式へ変換する必要はありません。そのうえで、次の3点を確認しておくと安心です。
- スキャンしたPDFが含まれていないか
- 図や表だけで説明している箇所に、要点を文章でも書き添えているか
- 1つのファイルに、関係のない複数のテーマが混ざっていないか
④ 分割・索引づくり・検索の設定をする
整えた文書をチャンクに分け、検索できる形にして索引(インデックス)に保存します。埋め込みモデルを使う構成ではチャンクをベクトル化して保存し、キーワード検索だけで構成する場合はベクトル化は不要です。あわせて、どのように検索するかを決めます。
検索の方式には主に次の種類があります。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
| 検索の方式 | 探し方 | 得意なこと |
|---|---|---|
| キーワード検索 | 入力した言葉が含まれる文書を探す | 型番や固有名詞など、言葉そのものの一致 |
| ベクトル検索 | 意味が近い文書を探す | 言い回しが違っても同じ内容を見つける |
| ハイブリッド検索 | 上の2つを組み合わせる | 両方の強みを活かす |
キーワード検索だけでは、言い回しの違いが壁になります。横浜市の選挙管理委員会では、印刷物の総称「文書図画」が、場面によって「ポスター」「ビラ」などと呼ばれるため、従来のキーワード検索では答えにたどり着けないことがあったと語られています。
出典:NTT東日本「横浜市が挑む、行政サービスにおける生成AIとRAGの活用。積み重ねてきたドキュメントが成功のカギ」
チャンクの大きさや検索の方式に、すべての文書に当てはまる正解はありません。文書の種類に合わせて設定し、次の⑤で確かめます。
⑤ 小さく試して精度を測る
②で用意した質問を使って、正しく答えられるかを確かめます。最初は限られた利用者で試し、課題を洗い出します。
小さく試す進め方(PoC:本格導入の前に小規模に試す取り組み)の考え方や費用の目安は、「PoC開発とは|新技術の実現可能性を検証する」で解説しています。PoCとMVPの違いは「PoCとMVPどちらから始めるべきか」をご覧ください。
確認するときは、次の2つを分けて見ると原因を特定しやすくなります。
- 検索の結果:質問に関係する文書を正しく見つけられているか
- 回答の内容:見つけた文書にもとづいて、正確に答えているか
検索で関係のない文書が出ていれば、分割の仕方や検索の方式を見直します。正しい文書が見つかっているのに回答が誤っていれば、AIへの指示文(プロンプト)を見直します。
なお、RAGを使っても、AIが事実と異なる回答をする可能性は残ります。Microsoftは対策として、参照元を示すことや、取得した文書に従うよう明確に指示することを挙げています。利用者にも、参照元を確認する習慣を伝えておきましょう。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
⑥ 運用しながら改善する
RAGは作って終わりではありません。参照する文書が古くなれば、回答も古くなります。
運用で決めておきたいことは次のとおりです。
- 規程の改定やマニュアルの更新時に、誰がいつ文書を入れ替えるか
- 答えられなかった質問や、誤った回答をどう集めて直すか
- ②の評価用の質問で、定期的に精度を確かめるか
モデル自体を学習し直さなくても、検索対象の文書を更新すれば最新の情報を回答に反映しやすいのは、RAGの利点です。ただし、文書の差し替えに加えて、検索用の索引の更新が必要な構成もあります。また、更新を担う人が決まっていないと、この利点は活かせません。
構築方法は3タイプ:ノーコード/クラウドサービス/自前実装
RAGの作り方は、大きく3つに分けられます。どれがよいかは、要件と運用体制で決まります。
| タイプ | 作り方 | 向いている場面 | 注意点 |
|---|---|---|---|
| ノーコードツール | 画面操作で文書を取り込み、チャットを作る | まず効果を確かめたい。対象の文書が限られている | 権限管理や既存システムとの連携は、ツールの機能の範囲に限られる |
| クラウドのマネージドサービス | クラウド事業者が用意したRAGの部品を組み合わせる | 社内で本格的に使いたい。すでにそのクラウドを使っている | 設定や連携には技術的な知識が必要。利用量に応じて費用がかかる |
| 自前実装 | 検索の仕組みや画面をプログラムで作る | 細かい要件がある。自社製品に組み込みたい | 開発と、その後の運用・改善を担う体制が必要(社内のエンジニア、または開発会社への委託) |
ノーコードツール
プログラムを書かずに、画面操作でRAGを試せるツールです。たとえばDifyでは、ファイルのアップロードやクラウドストレージ、Webページの取り込みなどから、ナレッジベース(RAGで参照するデータの置き場)を作れます。
出典:Dify Docs「ステップ 2:ナレッジパイプラインをオーケストレーションする」
少ない準備で動くものを試せるのが利点です。一方、細かい権限の制御や独自の画面を作り込む場合は、ツールで対応できる範囲を先に確認してください。
クラウドのマネージドサービス
マネージドサービスとは、サーバーの管理などをクラウド事業者に任せられるサービスです。主なものに、次があります。
- Amazon Bedrock ナレッジベース(AWS):文書の取り込みから検索までの一部を自動化し、RAGの設定と実装を簡単にすると説明されています
- Vertex AI RAG Engine(Google Cloud):Cloud StorageやGoogleドライブ、Slackなどのデータに接続できます
- Azure AI 検索(Microsoft):Microsoftが、RAG向けのインデックスストア(検索用データの保存先)として推奨している検索サービスです
すでに使っているクラウドがあれば、そのサービスから検討すると、アカウントや権限の管理をまとめやすくなります。
自前実装
検索の仕組み、AIの呼び出し方、画面などをプログラムで作る方法です。自由度が高い分、開発と運用の負担も大きくなります。
自前実装が向いているのは、次のようなケースです。
- 既存の社内システムや権限管理と細かく連携させたい。部署や役職ごとの閲覧権限を、検索結果にも正確に反映させたい場合です。
- 自社のアプリや製品に組み込みたい。社内向けのチャットではなく、顧客向けの機能として提供する場合です。画面や利用量の管理を自由に設計する必要があります。
- データの置き場所や外部送信に厳しい制約がある。「社外のクラウドにデータを出せない」といった要件がある場合です。
- 文書の形式が特殊で、標準の読み込みでは精度が出ない。図表の多い資料や独自形式の帳票などが中心の場合です。
- 精度を細かく調整し続けたい、AIモデルを入れ替えられるようにしたい。検索の方式や、使うAIモデルを評価結果を見ながら変えたい場合です。
- 運用・改善を続ける体制を用意できる。社内のエンジニアが担う形でも、開発会社に構築から運用・改善まで委託する形でも構いません。
自社のアプリやサービスに生成AI機能を組み込むときの設計・運用のポイントは、「生成AI機能の実装・運用ガイド2026」で解説しています。
逆に、次のような場合は、ノーコードツールやマネージドサービスから始めるほうが、時間も費用も抑えやすくなります。
- まず効果を確かめたい段階で、対象の文書も限られている
- 汎用的な社内Q&Aで、特別な連携や権限の要件がない
なお、社内に開発や運用を担えるエンジニアがいないことは、自前実装を諦める理由にはなりません。開発会社に構築と運用・改善を委託すれば、自前実装も選べます。どの作り方にするかは、社内の人員の有無ではなく、連携・権限・データの扱い・組み込み先といった要件で判断するのがおすすめです。
「全部自前」か「全部お任せ」の二択ではない
実際には、中間の選び方もあります。たとえばAmazon Bedrockのナレッジベースは、検索だけを行うAPI(システム同士がデータをやり取りするための窓口)も提供しています。RAGの各段階を切り離して、用途に合わせて組み立てられると説明されています。
出典:Amazon Bedrock ナレッジベースを使用してデータソースから情報を取得する
APIの仕組みは、「API連携とは?わかりやすく仕組みや活用例を図解で解説」をご覧ください。
つまり、「文書の管理と検索はクラウドに任せ、回答の作り方や画面は自社で作る」といった部分的な自前実装も可能です。
選び方の目安
迷ったときは、次の順で検討すると判断しやすくなります。
- ノーコードツールかマネージドサービスで、対象を絞って試す
- 試した結果、権限・連携・文書の形式などで壁に当たったら、その部分だけ自前実装を検討する
- 自社製品への組み込みなど、最初から要件がはっきりしている場合は、自前実装を前提に設計する
オプスインでは、RAGの作り方の選定や要件の整理からご相談をお受けしています。検討の途中でも、お問い合わせからご連絡ください。
事例:横浜市のRAG実証で見えたこと
横浜市の実証は、「文書の整備」と「評価用の質問」が結果を左右することを示した事例です。
横浜市は2024年11月から2025年3月まで、NTT東日本の支援を受けてRAGの実証を行いました。対象は、選挙管理事務、権利擁護業務(成年後見制度など)、データ活用業務の3つです。
出典:NTT東日本「横浜市のRAG実証をNTT東日本が伴走支援し成果を報告 ~選挙管理事務やデータ活用業務で生成AIを活用~」、2025年4月18日
選挙関連の問い合わせ業務では、次のように進められました。
出典:NTT東日本「横浜市が挑む、行政サービスにおける生成AIとRAGの活用。積み重ねてきたドキュメントが成功のカギ」、取材時点2025年5月
- 取り込んだ文書:法令や解説書などPDFで約4,500ページ分と、昭和46年以降に記録された約3,000件の質疑応答
- 文書の整備:さまざまな形のデータをテキストとして整理。プログラムと目視で、ノイズや文字化けの修正、段落の整理を行った
- 調整:指示文の調整や、文書の分け方(チャンク分割)の工夫
- 結果:あらかじめ用意した質問に対し、想定どおりの回答が得られるかで評価し、回答精度は約9割
一方で、課題も挙げられています。
- 構造化されていない文書や、図表の多い文書は扱いにくい
- 担当者だけが知っていて文書化されていない知識(暗黙知)は、そのままでは使えない
- 複数の分野にまたがる文書を組み合わせて答えることには限界を感じた
なお、「約9割」は用意した質問で測った数値です。どんな質問にも同じ精度で答えられるという意味ではありません。出典のページも、すべての利用者に同様の効果があることを保証するものではないと注記しています。
この事例から学べるのは、次の2点です。
- 回答の質の土台は、長年積み重ねた質疑応答などの文書と、その整備にある
- 精度は「用意した質問に正しく答えられるか」で具体的に測れる
構築前に確認したいセキュリティと社内ルール
RAGは社内文書を扱うため、「誰がどの文書を見られるか」と「データをどこに送るか」を構築前に決めておく必要があります。
閲覧権限を検索にも反映する
権限を考えずにすべての文書を検索対象にすると、本来見られないはずの情報がAIの回答に出てしまうおそれがあります。Microsoftも、文書へのアクセスを制御しないと機密情報が漏れる可能性があるとし、検索の時点でアクセス制御をかけるよう勧めています。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
たとえば人事評価の資料を含めるなら、人事部以外の社員の検索結果には出ないようにする必要があります。対応が難しい場合は、最初は全社員が見てよい文書だけで始めるのも一つの方法です。
取得した文書の中身を「命令」として扱わない
RAGでは、参照する文書そのものに、AIへの悪意ある指示が紛れ込んでいるケースにも注意が必要です。これを「プロンプトインジェクション」(AIへの指示を不正に書き換えようとする攻撃)といいます。Microsoftは、取得した文書を信頼できない入力として扱い、AIへの指示文やシステム側の処理で対策するよう勧めています。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
外部のAIサービスのデータの扱いを確認する
外部のAIを使う場合は、送ったデータがどう扱われるかを利用規約や公式の説明で確認します。
たとえばOpenAIは、APIや法人向けプランで送られた業務データを、初期設定ではモデルの学習に使わないと明記しています。APIの入出力は、不正利用の検知などのため原則最大30日保持されるとされています。条件はサービスや契約によって異なるため、使うサービスごとに確認してください。
出典:OpenAI「Enterprise privacy at OpenAI」、2026年1月8日更新
社内ルールを整える
AIの利用に関する社内ルールを作るときは、総務省と経済産業省の「AI事業者ガイドライン」が参考になります。最新の第1.2版は2026年3月31日に公表され、同日に「AI事業者ガイドライン活用の手引き(案)」も公表されています。
社内ルールでは、少なくとも次の点を決めておくと運用しやすくなります。
- RAGに取り込んでよい文書と、取り込んではいけない文書
- AIの回答をそのまま社外に出してよいか、人が確認するか
- 誤った回答を見つけたときの報告先
外部に依頼する場合に準備・決定しておくこと
開発会社に依頼する場合も、目的と文書に関する情報は発注側にしか用意できません。次の項目を整理しておくと、見積もりや打ち合わせが進めやすくなります。
- 対象の業務と利用者(誰が、どんな質問をするか)
- 参照させたい文書の一覧、おおよその量、保管場所、ファイル形式
- 文書の更新頻度と、更新の担当者
- 評価用の質問と正解(過去の問い合わせ履歴など)
- 部署や役職による閲覧権限の有無
- 社外のクラウドやAIサービスにデータを送ってよいか
- 連携したい既存システム(チャットツール、社内ポータル、文書管理システムなど)
- 公開後に運用・改善を担うのは社内か、依頼先か
費用と期間の考え方
RAGの構築費用や期間は、条件によって大きく変わります。主な変動要因は次のとおりです。
- 文書の量と状態(スキャン画像や図表が多いほど、整備に手間がかかる)
- 権限管理や既存システムとの連携の要否
- 構築方法(ノーコード/マネージドサービス/自前実装)
- 利用者数と質問の量
公開後も費用はかかります。Microsoftは、RAGでは検索の処理が加わり(ベクトル検索を使う場合は埋め込みの処理も加わり)、AIに渡す文章も長くなるため、その分の費用や応答時間が増えると説明しています。見積もりを比べるときは、初期費用だけでなく、月々の利用料や運用の手間も含めて確認しましょう。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
費用の目安(参考)
公式の料金ページをもとに、費用の目安をざっくり示します。料金は2026年9月時点のもので、税抜きのドル建てです。為替や料金改定で変わるため、導入前に必ず最新の料金を確認してください。
ノーコードツール(Difyのクラウド版の例)
- 無料のSandboxプラン:ナレッジに取り込める文書は50件まで
- Professionalプラン:1ワークスペースあたり年590ドル(年払い。メンバー3人、文書500件まで)
- Teamプラン:1ワークスペースあたり年1,590ドル(年払い。メンバー50人、文書1,000件まで)
- 付属のメッセージクレジットを使い切った後は、自社で契約したAIのAPIキーに切り替えて使えます。その場合、AIの利用料が別にかかります
出典:Dify Pricing
AIの利用料(使った分だけかかる従量課金)
AIの利用料は、AIが処理した文章の量に応じてかかります。量は「トークン」(AIが文章を処理するときの単位)で数えます。OpenAIの場合、100万トークンあたりの料金は次のとおりです。
- GPT-5.6 Terra(バランス型):入力2.00ドル、出力12.00ドル
- GPT-5.6 Luna(高速・低価格型):入力0.20ドル、出力1.20ドル
試算の条件(仮定):1回の質問で、質問文と検索した文書を合わせて5,000トークンをAIに渡し、500トークンの回答を受け取るとします。社員100人が1日10回、月20日使うと、月2万回です。
- GPT-5.6 Terraの場合:1回あたり約0.016ドル、月に約320ドル
- GPT-5.6 Lunaの場合:1回あたり約0.0016ドル、月に約32ドル
実際のトークン数は、文書の分け方や一度に渡す文書の数で変わります。規模感をつかむための目安としてご覧ください。
なお、この試算はAIが回答を生成する部分の利用料だけです。埋め込み(ベクトル化)、検索基盤、ストレージ、OCR、アプリケーションを動かすサーバーなどの費用は含みません。
クラウドのマネージドサービス
検索の基盤、(ベクトル検索を使う場合は)ベクトルの保存、AIの利用などが、それぞれ使った分だけかかる料金体系です。たとえばAzure AI 検索には、容量50MBまでの無料プランと、容量に応じた有料プランがあります。AWSでは、図表を読み取る解析方法を使うと、ページ数やトークン数に応じた料金が加わります。構成によって金額が大きく変わるため、各社の料金計算ツールで見積もるのが確実です。
出典:Azure AI Search の価格、データソースの解析オプション
構築費用(開発会社に依頼して自前実装する場合)
要件、文書の量と状態、連携するシステムによって大きく変わります。
【要記入:オプスインでの構築費用の目安(例:PoC/本番構築/月額の運用委託)】
運用費用
公開後は、上のAI利用料やツール・クラウドの利用料に加えて、文書の更新や精度の確認にかかる社内の人件費、または開発会社への運用委託費がかかります。
よくある質問
RAG構築にはどのくらいの期間がかかりますか?
対象業務、文書の量と状態、連携するシステムによって大きく変わります。オプスインでは、小規模な検証(PoC)の期間を1〜3か月程度を目安としています。本格的な社内展開の期間は、検証の結果を見て計画します。
どのくらいの文書があれば始められますか?
対象業務を絞れば、限られた文書からでも始められます。まずは問い合わせの多い業務のマニュアルやFAQから始め、評価用の質問で精度を確かめながら、文書と対象範囲を広げていく進め方がおすすめです。
RAGを使えば、AIの回答の誤りはなくなりますか?
なくなるわけではありません。Microsoftも、関連する文書を取得できていても、AIが不正確な回答を生成する可能性があるとしています。回答に参照元を示し、利用者が確認できるようにしておくことが大切です。
出典:Microsoft Foundry での拡張生成 (RAG) とインデックスの取得
社内の機密情報を扱っても大丈夫ですか?
閲覧権限を検索にも反映する設計と、外部のAIサービスでのデータの扱いの確認が前提になります。詳しくは、この記事の「構築前に確認したいセキュリティと社内ルール」をご覧ください。
まとめ
RAG構築で大切なのは、作り方より先に「目的」「評価の基準」「文書」を整えることです。
- RAGは、AIが社内文書を検索してから答える仕組みで、AIそのものを学習し直す方法ではない
- 全体像は「データを準備する流れ」と「質問に答える流れ」の2つでとらえる
- 手順は、目的の決定 → 評価用の質問づくり → 文書の整備 → 構築 → 小さく試す → 運用・改善の6ステップ
- 構築方法はノーコード/マネージドサービス/自前実装の3つ。まず小さく試し、壁に当たった部分を自前実装で補う考え方もある
- 閲覧権限とデータの送り先は、構築前に決めておく
最初の一歩として、「よく来る社内の問い合わせ」と「その答えが書かれた文書」を書き出してみてください。それが、対象業務の決定と評価用の質問づくりの素材になります。
RAGの構築や社内ナレッジの活用について相談したい場合は、オプスインのお問い合わせからご連絡ください。